ベースモデルを選ぶ
Krea 2、FLUX、Qwen Image、Z-Imageは得意な表現が異なります。選んだモデルでLoRAをファインチューニングします。
 Loras AI
あなたの画像でファインチューニングしたLoRA。
Loras AIは4〜30枚の画像をLoRAに学習します。LoRAは軽量なファインチューニングモデルで、キャラクター・商品・画風を新しい画像でも一貫して保ちます。GPUもコードも不要です。
Quick answer: Train supported image and video LoRAs with configured services, sufficient credits and a compatible dataset. Each LoRA must use its paired generator; catalog listings do not establish compatibility.
少数のテーマを絞った画像でLoRAを学習できます。
よく使われる3つの学習用途に対応したプリセット。
FLUX、Krea 2、Qwen Image、Z-Imageに加え、WanとLTXの動画モデルに対応。
学習前に各キャプションとトリガーワードを確認できます。
学習の進捗を確認し、完成したモデルを再利用できます。
送信前に必要なクレジット数を確認できます。
学習と生成はクラウドで実行されます。
English、中文、日本語、한국어。
Loras AI Image と Loras AI Video で生成した画像と動画です。クリックするとプロンプトを使えます。
これらはAIで作成したオリジナルのコンセプト参考画像です。Lorasの学習結果、前後比較、モデル性能の証明ではありません。
画像から、何度でも使えるファインチューニングモデルまで。
1つのキャラクター・商品・画風の鮮明な画像を4〜30枚追加し、学習前に画像とキャプションを確認します。
ベースモデルを選んでファインチューニングを開始。LoRAはクラウドで学習し、進捗はマイLoRAで確認できます。
ファインチューニングしたモデルで新しいシーンを生成。被写体は同じまま保たれます。
ハードウェアの準備もコードも不要で、LoRAに必要なものが揃っています。
| 比較項目 | Loras AI | ローカル学習 | 開発者向けAPI |
|---|---|---|---|
| 自前のGPUが必要 | 不要 | 必要(大容量VRAM) | 不要 |
| コーディングが必要 | 不要 | 環境構築が必要 | 必要 |
| データセット・キャプション機能 | 内蔵 | 別ツール | 自作 |
| 学習後の生成 | 同じワークスペース | 別途セットアップ | 自作 |
| 料金 | タスクごとのクレジット | ハードウェアと電気代 | リクエスト課金 |
Krea 2はクラウド学習と対応する画像生成を提供します。MOSSとAnimaには専用の生成ワークフローがあります。動画モデルの調査や下書きツールも利用できます。学習・生成にはログインと十分なクレジットが必要です。
LoRAはモデルごとに互換性の確認が必要です。別モデルの重みをそのまま流用することはできません。解像度と必要クレジットは生成画面で確認できます。
Costs and limits below follow the application configuration. Integration describes the code, not verified provider uptime or a successful live training run.
| Model | Integration | Cloud input limits | Credits and settings | Output and compatibility |
|---|---|---|---|---|
| Krea 2 | Integrated; configuration required | 1–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 100 credits / task. Generation: 10 credits / image. Fixed training steps: 100. | LoRA weights after success; use the paired Krea 2 generator. Compatibility with other base models is not implied. |
| FLUX.1 Dev | Integrated; configuration required | 4–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 167 credits / task. Generation: 10 credits / image. Fixed training steps: 500. | LoRA weights after success; use the paired FLUX.1 Dev generator. Compatibility with other base models is not implied. |
| FLUX.2 Dev | Integrated; configuration required | 10–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 2134 credits / task. Generation: 14 credits / image. Fixed training steps: 1000. | LoRA weights after success; use the paired FLUX.2 Dev generator. Compatibility with other base models is not implied. |
| Qwen Image 2512 | Integrated; configuration required | 4–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 167 credits / task. Generation: 10 credits / image. Fixed training steps: 500. | LoRA weights after success; use the paired Qwen Image 2512 generator. Compatibility with other base models is not implied. |
| Z-Image Turbo | Integrated; configuration required | 4–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 209 credits / task. Generation: 10 credits / image. Fixed training steps: 500. | LoRA weights after success; use the paired Z-Image Turbo generator. Compatibility with other base models is not implied. |
| Wan 2.2 | Integrated; configuration required | 3–10 MP4 clips with a trigger phrase. Up to 8 MiB per clip; 24 MiB total. | Training: 1667 credits / task. Generation: 67 credits / 5-second video. Fixed training steps: 100. | LoRA weights after success; use the paired Wan 2.2 generator. Compatibility with other base models is not implied. |
| LTX-2 19B | Integrated; configuration required | 3–10 MP4 clips with a trigger phrase. Up to 8 MiB per clip; 24 MiB total. | Training: 584 credits / task. Generation: 34 credits / 5-second video. Fixed training steps: 500. | LoRA weights after success; use the paired LTX-2 19B generator. Compatibility with other base models is not implied. |
Cloud tasks require sign-in and sufficient credits. Krea 2 needs Fal; WaveSpeed image and video trainers need WaveSpeed access and R2 storage.
Cloud training sends your selected media and captions to the provider. Image and video dataset limits differ. Confirm account readiness before submitting.
目的に沿ったワークフロー
LoRAは軽量なファインチューニングモデルです。ベースモデル全体を再学習せず、少数の画像から1つのキャラクター・画風・商品を学びます。Loras AIがデータセット、キャプション、学習をまとめて扱うので、数枚の画像が再利用できるファインチューニングモデルになります。
Krea 2、FLUX、Qwen Image、Z-Imageは得意な表現が異なります。選んだモデルでLoRAをファインチューニングします。
サイズや重複を確認し、角度・光・背景に意味のある変化を残しましょう。
画像ごとに変わる要素を説明し、モデルが被写体だけを学ぶようにします。学習前にトリガーワードを確認しましょう。
学習が終わったらマイLoRAから開き、ファインチューニングしたモデルで新しいシーンを生成します。
学習させたいアイデア
学習コンセプトを定める3つの方法を紹介します。各参考画像から、データの準備や評価用プロンプトを扱う専用ワークフローへ進めます。
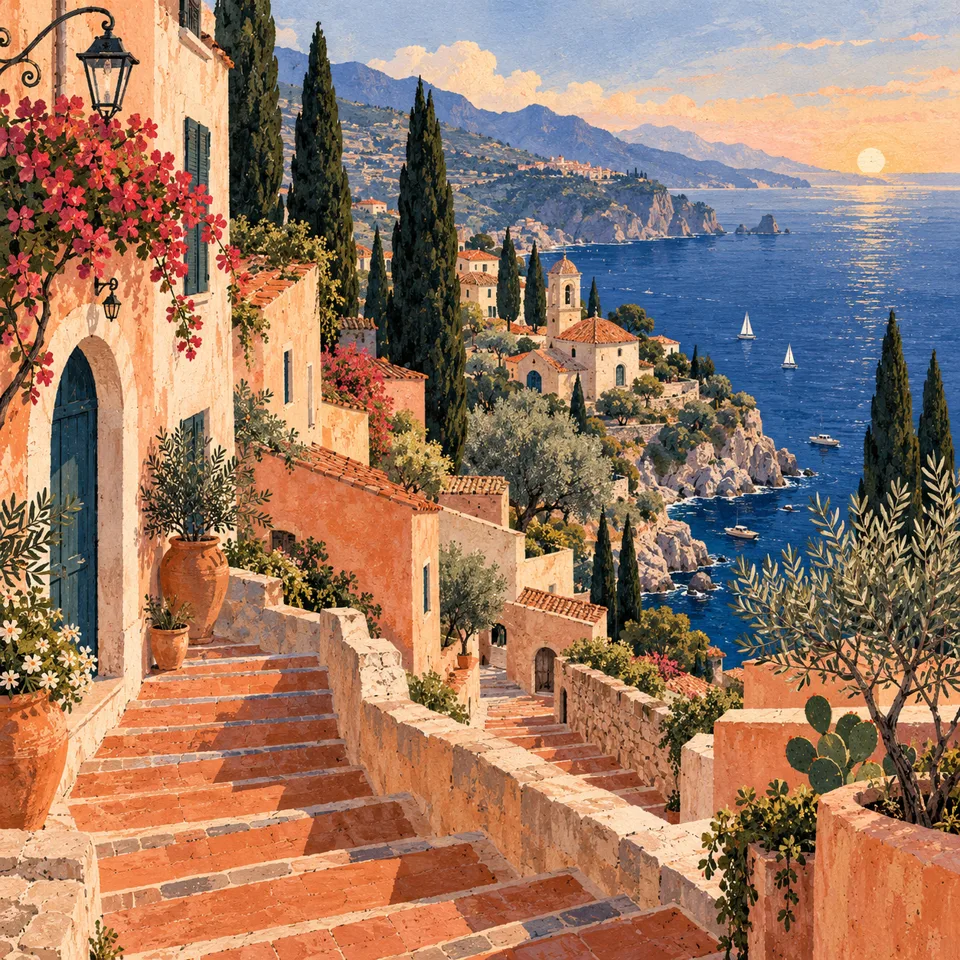
海辺のイラストを視覚表現の参考に使います。素材感、色、線の描き方を揃えながら、描く対象は変えていきましょう。
キャプション例ohwx_styleで描いた海辺の村。ガッシュの質感、暖かく平面的な色、細いインクの輪郭。
スタイルLoRAの学習を見る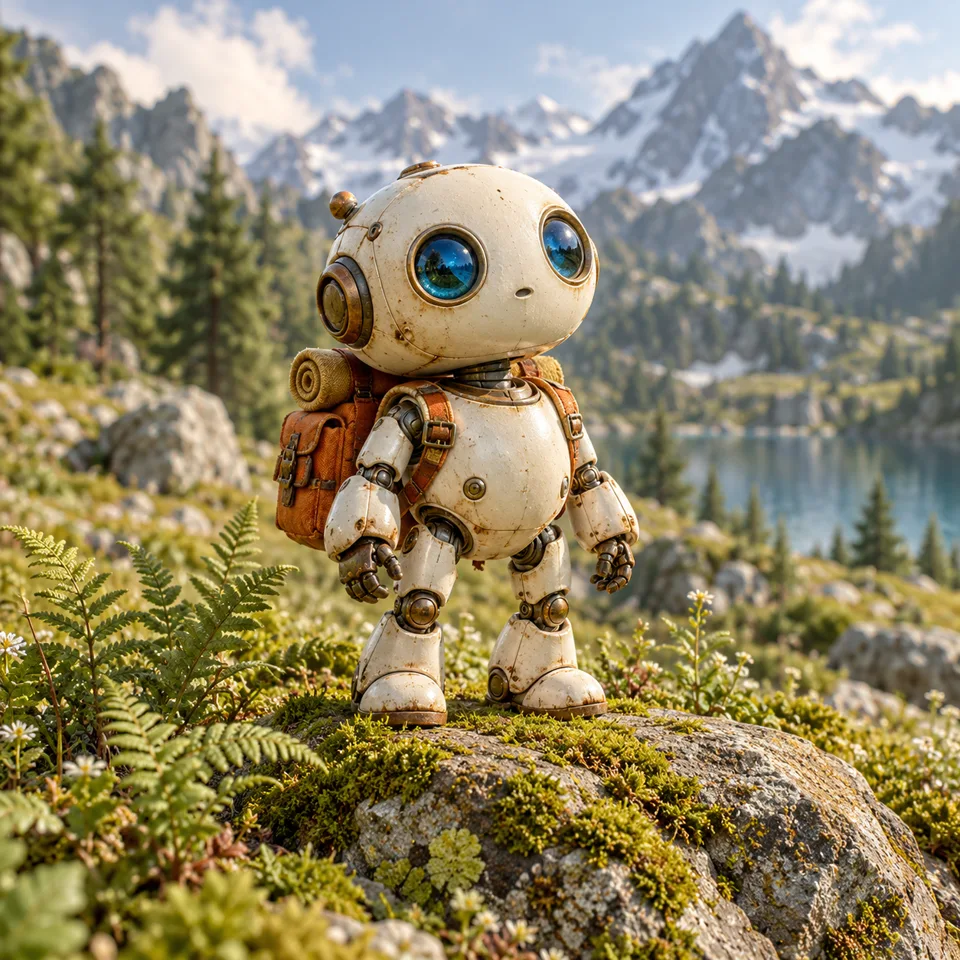
オリジナルの陶器の探検ロボットが、データセットの核になります。同じ構図を繰り返すのではなく、角度、ポーズ、背景を変えましょう。
キャプション例ohwx_robot、青いガラスの目を持つ陶器の探検ロボット。昼間、高山の湖のそばに立っている。
キャラクターLoRAの学習を見る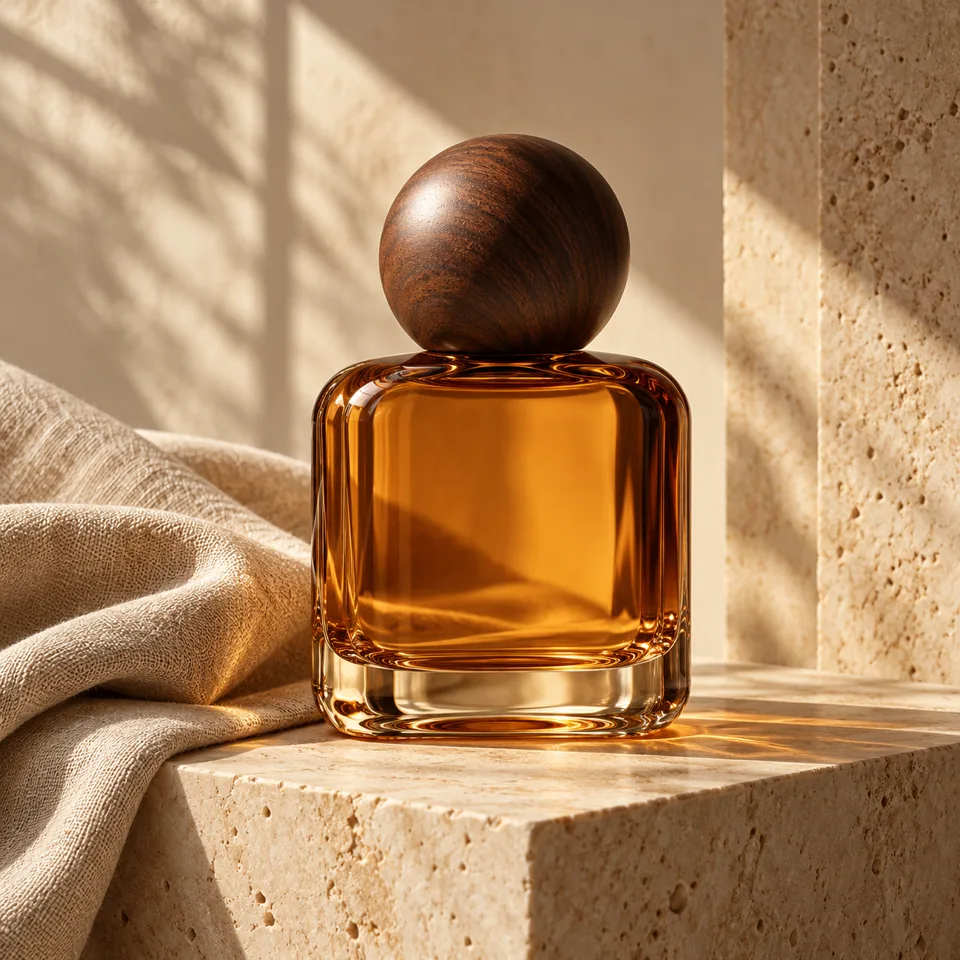
無地の琥珀色のボトルで、形と素材を明確にします。1つの背景だけを学習させず、ガラスの本体やキャップを別の角度からも見せましょう。
キャプション例ohwx_bottle、丸いウォールナットのキャップが付いた琥珀色のガラス瓶。窓からの光が当たるトラバーチンの台の上。
商品LoRAの学習を見るこれらはAIで作成したオリジナルのコンセプト参考画像です。Lorasの学習結果、前後比較、モデル性能の証明ではありません。
目的の設定から評価まで
画像とキャプションをブラウザー内で整え、提供中のKrea 2学習に送信。完了した重みは対応する生成画面で試せます。他のモデルを選ぶ前には対応状況と互換性を確認してください。
データセットと互換性
LoRAはファインチューニングしたベースモデルファミリーでしか動作しません。FLUXのLoRAはKrea 2、Qwen Image、Wanでは読み込めないため、画像を準備する前にベースモデルを選びましょう。
データセット準備ガイドを読むプロンプトノート
学習済みの対応アダプターを評価するときの参考にしてください。これらはプロンプト例であり、生成結果や一貫した出力を保証するものではありません。
ohwx_styleで描いた丘の上の図書館。暖かいフラットカラー、紙の質感、繊細なインクの輪郭。
ohwx_styleのヴィンテージ卓上ランプ。シンプルな構図、暖かい黄土色と藍色の配色。
ohwx_styleの雨上がりの静かな森の小道。重なり合う形、はっきりとしたガッシュの質感。
ohwx_styleの小さな帆船。大胆で単純化した形、柔らかい紙の粒子感、文字なし。
ohwx_styleのオリジナルの架空の庭師。全身のポーズ、シンプルで淡い背景。
ohwx_styleの夜市。抑えた青と琥珀色の配色、手描きの細部。
関連ガイド
画像の選び方、キャプション、学習設定、モデルが何を学んだかを評価するための実用ガイドです。
FAQ
モデルごとの注意点と、現在利用できる機能をまとめました。
LoRAはファインチューニングモデルの一種です。フルファインチューニングはベースモデル全体を再学習しますが、LoRAは小さな追加ファイルだけを学習するため、必要な画像や計算量がずっと少なく、ベースモデルに重ねて読み込みます。
学習画面で対応するベースモデルを選び、1つの被写体の画像を4〜30枚アップロードしてキャプションを確認します。送信前に必要なクレジットが表示され、完成したLoRAはマイLoRAからすぐに生成に使えます。
Krea 2のクラウド学習と対応する画像生成を利用できます。MOSSとAnimaには、対応LoRAを使える専用の画像生成画面があります。ログインと十分なクレジットが必要で、費用は送信前に表示されます。他のモデルの学習、自動キャプション、クラウド動画生成は未提供です。ローカル準備とJSON書き出しは無料です。
ローカル下書きでは画像を現在のブラウザータブ内で処理し、書き出したJSONに元画像は含めません。再読み込みやページ移動でローカル画像は消去されます。Krea 2クラウド学習を送信すると、画像データセットとキャプションが学習サービスへ送られます。画像生成ではプロンプトと選択したLoRA参照が対応サービスへ送られます。使用権のある素材のみ送信してください。
そのまま使い回すことはできません。モデルの構造、基本バージョン、読み込み手順を合わせる必要があります。Krea 2、MOSS、Animaにはそれぞれ対応する重みが必要です。名前が似ていても互換性は保証されません。動画では複数のアダプターファイルが必要な場合もあります。
さらに探す
学習を始める前に、関連するモデルを比較しましょう。アダプター形式と基本モデルのバージョンは合わせる必要があります。
対応するモデルを選び、画像とキャプションを整えて、提供中の学習や生成に送信できます。データセット設定の下書きを無料で書き出すこともできます。
4〜30枚の画像から、一貫性を保つLoRAを。