기반 모델 선택
Krea 2, FLUX, Qwen Image, Z-Image는 잘하는 표현이 다릅니다. 선택한 모델에서 LoRA를 파인튜닝합니다.
 Loras AI
내 이미지로 파인튜닝한 LoRA.
Loras AI는 이미지 4~30장을 LoRA로 학습합니다. LoRA는 가벼운 파인튜닝 모델로, 캐릭터·제품·화풍을 새 이미지에서도 일관되게 유지합니다. GPU도 코드도 필요 없습니다.
Quick answer: Train supported image and video LoRAs with configured services, sufficient credits and a compatible dataset. Each LoRA must use its paired generator; catalog listings do not establish compatibility.
주제가 명확한 소규모 데이터셋으로 LoRA를 학습할 수 있습니다.
가장 많이 사용하는 세 가지 학습 용도의 프리셋.
FLUX, Krea 2, Qwen Image, Z-Image와 Wan, LTX 동영상 모델을 지원합니다.
학습 전에 모든 캡션과 트리거 단어를 확인하세요.
학습 진행 상황을 확인하고 완성된 모델을 재사용하세요.
제출 전에 필요한 크레딧이 표시됩니다.
학습과 생성은 클라우드에서 실행됩니다.
English, 中文, 日本語, 한국어.
Loras AI Image와 Loras AI Video로 생성한 이미지와 동영상입니다. 클릭하면 프롬프트를 사용할 수 있습니다.
이 이미지는 AI로 만든 독창적인 콘셉트 참고 자료입니다. Loras의 학습 결과, 전후 비교 또는 모델 성능을 증명하는 자료가 아닙니다.
이미지에서 계속 쓸 수 있는 파인튜닝 모델까지.
하나의 캐릭터·제품·화풍의 선명한 이미지 4~30장을 추가하고, 학습 전에 이미지와 캡션을 확인하세요.
기본 모델을 고르고 파인튜닝을 시작하세요. LoRA는 클라우드에서 학습되며 진행 상황은 내 LoRA에서 확인할 수 있습니다.
파인튜닝한 모델로 새로운 장면을 만들어도 피사체는 그대로 유지됩니다.
하드웨어 준비나 코딩 없이 LoRA에 필요한 모든 것을 제공합니다.
| 비교 항목 | Loras AI | 로컬 학습 | 개발자 API |
|---|---|---|---|
| 개인 GPU 필요 | 필요 없음 | 필요(대용량 VRAM) | 필요 없음 |
| 코딩 필요 | 필요 없음 | 환경 설정 필요 | 필요 |
| 데이터셋·캡션 도구 | 기본 제공 | 별도 도구 | 직접 개발 |
| 학습 후 생성 | 같은 작업 공간 | 별도 설정 | 직접 개발 |
| 결제 방식 | 작업당 크레딧 | 하드웨어와 전기료 | 요청당 과금 |
Krea 2는 클라우드 학습과 해당 모델의 이미지 생성을 지원합니다. MOSS와 Anima는 별도의 생성 작업 공간을 제공하며, 동영상 모델 탐색과 초안 도구도 이용할 수 있습니다. 학습과 생성에는 로그인 및 충분한 크레딧이 필요합니다.
각 모델에 맞는 LoRA가 필요하며 가중치를 다른 모델에 그대로 사용할 수는 없습니다. 해상도와 필요한 크레딧은 생성 화면에서 확인할 수 있습니다.
Costs and limits below follow the application configuration. Integration describes the code, not verified provider uptime or a successful live training run.
| Model | Integration | Cloud input limits | Credits and settings | Output and compatibility |
|---|---|---|---|---|
| Krea 2 | Integrated; configuration required | 1–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 100 credits / task. Generation: 10 credits / image. Fixed training steps: 100. | LoRA weights after success; use the paired Krea 2 generator. Compatibility with other base models is not implied. |
| FLUX.1 Dev | Integrated; configuration required | 4–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 167 credits / task. Generation: 10 credits / image. Fixed training steps: 500. | LoRA weights after success; use the paired FLUX.1 Dev generator. Compatibility with other base models is not implied. |
| FLUX.2 Dev | Integrated; configuration required | 10–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 2134 credits / task. Generation: 14 credits / image. Fixed training steps: 1000. | LoRA weights after success; use the paired FLUX.2 Dev generator. Compatibility with other base models is not implied. |
| Qwen Image 2512 | Integrated; configuration required | 4–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 167 credits / task. Generation: 10 credits / image. Fixed training steps: 500. | LoRA weights after success; use the paired Qwen Image 2512 generator. Compatibility with other base models is not implied. |
| Z-Image Turbo | Integrated; configuration required | 4–30 JPEG, PNG or WebP images with captions and a trigger phrase. Up to 15 MiB per image; 25 MiB total. | Training: 209 credits / task. Generation: 10 credits / image. Fixed training steps: 500. | LoRA weights after success; use the paired Z-Image Turbo generator. Compatibility with other base models is not implied. |
| Wan 2.2 | Integrated; configuration required | 3–10 MP4 clips with a trigger phrase. Up to 8 MiB per clip; 24 MiB total. | Training: 1667 credits / task. Generation: 67 credits / 5-second video. Fixed training steps: 100. | LoRA weights after success; use the paired Wan 2.2 generator. Compatibility with other base models is not implied. |
| LTX-2 19B | Integrated; configuration required | 3–10 MP4 clips with a trigger phrase. Up to 8 MiB per clip; 24 MiB total. | Training: 584 credits / task. Generation: 34 credits / 5-second video. Fixed training steps: 500. | LoRA weights after success; use the paired LTX-2 19B generator. Compatibility with other base models is not implied. |
Cloud tasks require sign-in and sufficient credits. Krea 2 needs Fal; WaveSpeed image and video trainers need WaveSpeed access and R2 storage.
Cloud training sends your selected media and captions to the provider. Image and video dataset limits differ. Confirm account readiness before submitting.
목표에 맞춘 작업 흐름
LoRA는 가벼운 파인튜닝 모델입니다. 기반 모델 전체를 다시 학습하지 않고 적은 이미지로 하나의 캐릭터·화풍·제품을 학습합니다. Loras AI가 데이터셋, 캡션, 학습을 처리해 이미지 몇 장을 계속 쓸 수 있는 파인튜닝 모델로 만들어 줍니다.
Krea 2, FLUX, Qwen Image, Z-Image는 잘하는 표현이 다릅니다. 선택한 모델에서 LoRA를 파인튜닝합니다.
크기와 중복을 확인하고 각도·조명·배경의 유용한 변화를 남기세요.
이미지마다 달라지는 요소를 설명해 모델이 피사체만 학습하게 하세요. 학습 전에 트리거 단어를 확인하세요.
학습이 끝나면 내 LoRA에서 열고 파인튜닝한 모델로 새로운 장면을 생성하세요.
학습하고 싶은 아이디어
학습 콘셉트를 정하는 세 가지 방법을 살펴보세요. 각 참고 이미지에서 데이터 준비와 평가 프롬프트를 다루는 작업 흐름으로 이동할 수 있습니다.
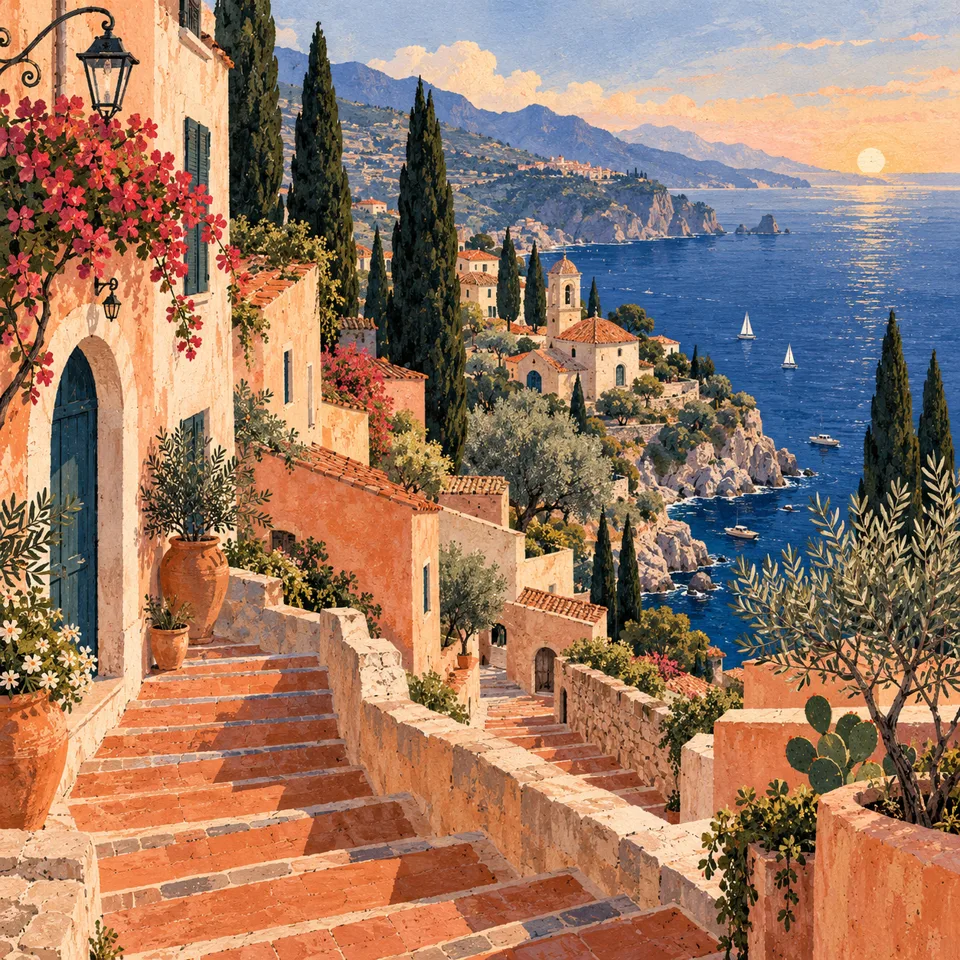
해안 마을 일러스트를 시각 표현의 참고로 사용하세요. 질감, 색상, 선 표현은 일관되게 유지하면서 소재를 다양하게 구성하세요.
캡션 예시ohwx_style로 그린 해안 마을, 과슈 질감, 따뜻하고 평면적인 색상, 섬세한 잉크 윤곽선.
스타일 LoRA 학습 알아보기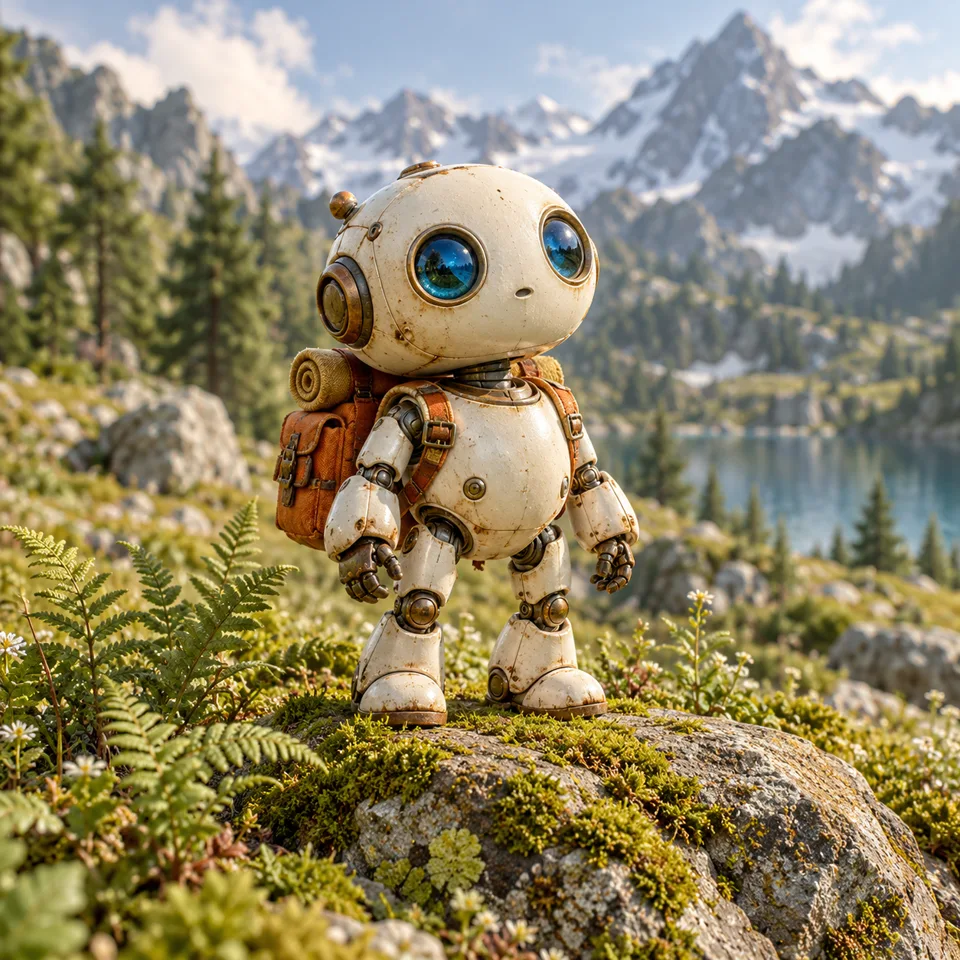
독창적인 도자기 탐험 로봇이 데이터셋의 중심이 됩니다. 같은 구도를 반복하기보다 시점, 자세, 배경을 바꿔 보세요.
캡션 예시ohwx_robot, 파란 유리 눈을 가진 도자기 탐험 로봇이 낮에 산속 호수 옆에 서 있다.
캐릭터 LoRA 학습 알아보기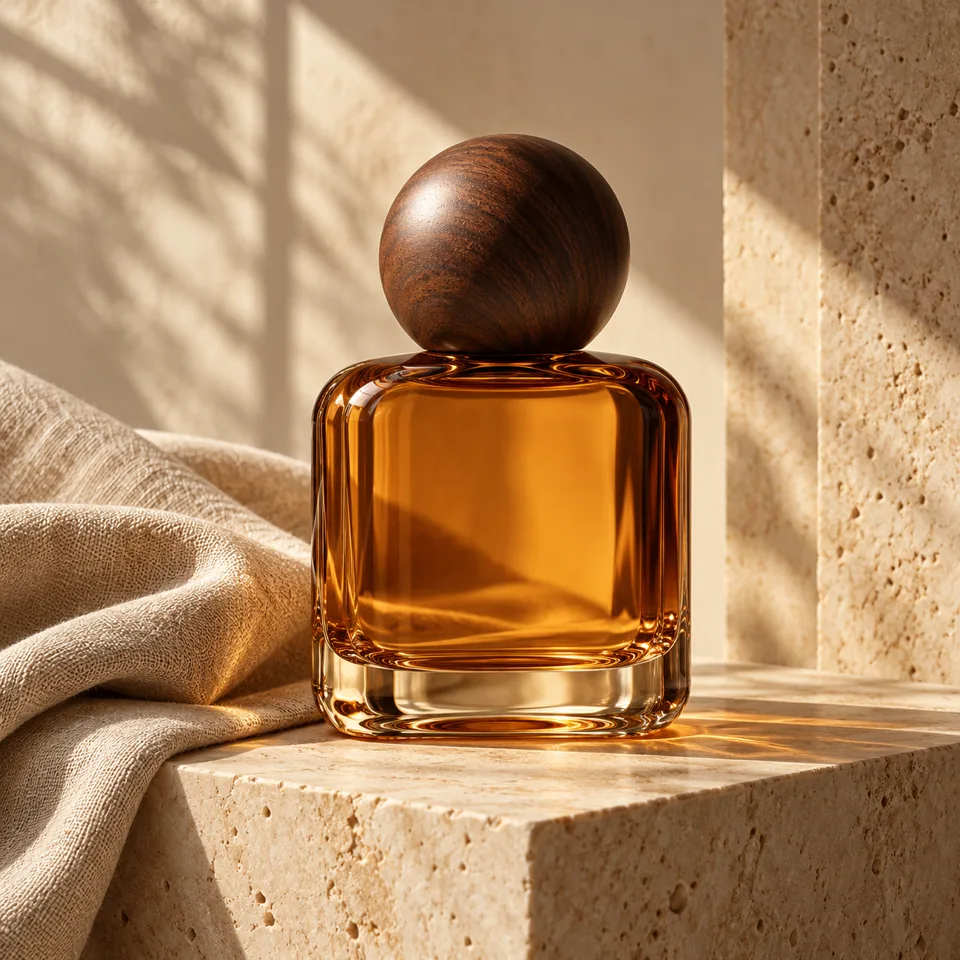
라벨 없는 호박색 병으로 형태와 소재를 명확하게 표현하세요. 하나의 배경만 학습시키지 않도록 유리 본체와 뚜껑을 여러 각도에서 보여 주세요.
캡션 예시ohwx_bottle, 둥근 월넛 뚜껑이 달린 호박색 유리병이 창가 빛을 받는 트래버틴 표면 위에 놓여 있다.
제품 LoRA 학습 알아보기이 이미지는 AI로 만든 독창적인 콘셉트 참고 자료입니다. Loras의 학습 결과, 전후 비교 또는 모델 성능을 증명하는 자료가 아닙니다.
목표 설정부터 평가까지
브라우저에서 이미지와 캡션을 준비한 뒤 지원되는 Krea 2 학습에 제출하세요. 완료된 가중치는 해당 생성 화면에서 시험할 수 있습니다. 다른 모델을 선택하기 전에는 지원 여부와 호환성을 확인하세요.
일관된 캐릭터, 응용할 수 있는 스타일, 독특한 제품, 특정 동작 중 무엇을 학습할지 정하세요.
가이드 읽기학습할 콘셉트는 일관되게 유지하되 모델이 고정적으로 외우지 않아야 할 세부 요소는 다양하게 구성하세요.
가이드 읽기이미지 크기를 확인하고 각 캡션을 편집한 뒤 작업 공간을 나가기 전에 로컬 설정을 내보내세요.
가이드 읽기학습을 마친 호환 LoRA를 새로운 프롬프트로 시험하세요. 모델, 설정, 성공과 실패 사례를 기록하고 기반 모델과 비교해 콘셉트를 평가하세요.
가이드 읽기데이터셋과 호환성
LoRA는 파인튜닝한 기반 모델 패밀리에서만 작동합니다. FLUX LoRA는 Krea 2, Qwen Image, Wan에서 불러올 수 없으므로 이미지를 준비하기 전에 기반 모델을 고르세요.
데이터셋 준비 가이드 읽기프롬프트 노트
학습한 호환 어댑터를 평가할 때 참고하세요. 이 내용은 프롬프트 예시이며 생성 결과나 일관된 출력을 보장하지 않습니다.
ohwx_style로 그린 언덕 위 도서관, 따뜻하고 평면적인 색상, 종이 질감, 섬세한 잉크 윤곽선.
ohwx_style의 빈티지 탁상 램프, 단순한 구도, 따뜻한 황토색과 남색 팔레트.
ohwx_style의 비 온 뒤 고요한 숲길, 겹쳐진 형태, 눈에 띄는 과슈 질감.
ohwx_style의 작은 범선, 대담하고 단순한 형태, 부드러운 종이 입자감, 글자 없음.
ohwx_style의 독창적인 가상 정원사, 전신 자세, 단순하고 옅은 배경.
ohwx_style의 야시장, 절제된 파란색과 호박색 팔레트, 손으로 그린 세부 표현.
관련 가이드
이미지 선택, 캡션, 학습 설정, 모델이 실제로 학습한 내용을 평가하는 실용 가이드입니다.
FAQ
모델별 주의 사항과 현재 이용할 수 있는 기능을 안내합니다.
LoRA는 파인튜닝 모델의 한 종류입니다. 전체 파인튜닝은 기반 모델 전체를 다시 학습하지만, LoRA는 작은 추가 파일만 학습하므로 필요한 이미지와 연산이 훨씬 적고 기반 모델 위에 불러와 사용합니다.
학습 화면에서 지원되는 기반 모델을 고르고 하나의 피사체 이미지 4~30장을 올린 뒤 캡션을 확인하세요. 제출 전에 필요한 크레딧이 표시되며, 완성된 LoRA는 내 LoRA에서 바로 생성에 사용할 수 있습니다.
Krea 2 클라우드 학습과 해당 모델의 이미지 생성을 이용할 수 있습니다. MOSS와 Anima에는 호환 LoRA를 사용할 수 있는 별도의 이미지 생성 화면이 있습니다. 로그인과 충분한 크레딧이 필요하며 비용은 제출 전에 표시됩니다. 다른 모델의 학습, 자동 캡션, 클라우드 동영상 생성은 아직 지원하지 않습니다. 로컬 준비와 JSON 내보내기는 무료입니다.
로컬 초안은 현재 브라우저 탭에서 이미지를 처리하며 내보낸 JSON에는 원본 이미지가 포함되지 않습니다. 새로고침하거나 페이지를 떠나면 로컬 이미지가 지워집니다. Krea 2 클라우드 학습을 제출하면 이미지 데이터셋과 캡션이 학습 서비스로 전송됩니다. 이미지 생성 시에는 프롬프트와 선택한 LoRA 참조가 해당 서비스로 전송됩니다. 사용 권한이 있는 자료만 제출하세요.
그대로 돌려 쓸 수는 없습니다. 모델 구조, 기반 버전, 로딩 방식이 맞아야 합니다. Krea 2, MOSS, Anima에는 각각 호환되는 가중치가 필요합니다. 모델 이름이 비슷해도 호환성이 보장되지는 않습니다. 동영상 작업에는 여러 어댑터 파일이 필요할 수도 있습니다.
더 알아보기
학습을 시작하기 전에 관련 모델을 비교하세요. 어댑터 형식과 기반 모델 버전이 호환되어야 합니다.
호환되는 모델을 선택하고 이미지와 캡션을 준비한 뒤 지원되는 학습이나 생성에 제출하세요. 데이터셋 설정 초안을 무료로 내보낼 수도 있습니다.
이미지 4~30장으로 일관성을 지키는 LoRA를 만드세요.