匹配基础模型
选择流程前,比较模型家族、版本与开放情况。
 Loras AI
LoRA 训练 / 角色 LoRA
准备原创或已获授权的角色数据集,有意识地变化姿势、表情、视角和背景,并探索兼容的基础模型流程。
简明说明: 配置服务并准备足够积分及兼容数据集后,可训练已支持的图片和视频 LoRA。每种 LoRA 必须使用对应生成器;目录展示不代表模型互相兼容。
已接入 Krea 2、FLUX.1、FLUX.2 Dev、Qwen Image、Z-Image、Wan 2.2 I2V 和 LTX-2 19B 云端训练。提交前请配置所需服务、登录并核对积分报价。
添加你希望模型学习的风格、角色或物体图片。
提交前素材仅在当前标签页;提交 Krea 2 训练后,图片和描述会上传到 fal。刷新会清空本地文件,但云端任务可在「我的 LoRA」继续查看。
使用同一角色的不同角度、表情、光线和背景,减少不必要的关联。
以下费用和限制读取自应用配置。已接入表示代码具备相关功能,不代表已核实供应商实时状态或完成真实训练验证。
| 模型 | 接入状态 | 云端输入限制 | 积分与参数 | 输出与兼容性 |
|---|---|---|---|---|
| Krea 2 | 已接入,需配置服务 | 1–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 100 积分;生成每张 10 积分;固定训练步数 100。 | 成功后获得 LoRA 权重,使用配对的 Krea 2 生成模型;不代表与其他基础模型兼容。 |
| FLUX.1 Dev | 已接入,需配置服务 | 4–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 167 积分;生成每张 10 积分;固定训练步数 500。 | 成功后获得 LoRA 权重,使用配对的 FLUX.1 Dev 生成模型;不代表与其他基础模型兼容。 |
| FLUX.2 Dev | 已接入,需配置服务 | 10–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 2134 积分;生成每张 14 积分;固定训练步数 1000。 | 成功后获得 LoRA 权重,使用配对的 FLUX.2 Dev 生成模型;不代表与其他基础模型兼容。 |
| Qwen Image 2512 | 已接入,需配置服务 | 4–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 167 积分;生成每张 10 积分;固定训练步数 500。 | 成功后获得 LoRA 权重,使用配对的 Qwen Image 2512 生成模型;不代表与其他基础模型兼容。 |
| Z-Image Turbo | 已接入,需配置服务 | 4–30 张 JPEG、PNG 或 WebP 图片,配合描述和触发词。单张最多 15 MiB,合计最多 25 MiB。 | 训练每次 209 积分;生成每张 10 积分;固定训练步数 500。 | 成功后获得 LoRA 权重,使用配对的 Z-Image Turbo 生成模型;不代表与其他基础模型兼容。 |
| Wan 2.2 | 已接入,需配置服务 | 3–10 个 MP4 片段及触发词。单个最多 8 MiB,总计最多 24 MiB。 | 训练:每次 1667 积分;生成:每 5 秒视频 67 积分;固定训练步数:100。 | 成功后获得 LoRA 权重,使用配对的 Wan 2.2 生成模型;不代表与其他基础模型兼容。 |
| LTX-2 19B | 已接入,需配置服务 | 3–10 个 MP4 片段及触发词。单个最多 8 MiB,总计最多 24 MiB。 | 训练:每次 584 积分;生成:每 5 秒视频 34 积分;固定训练步数:500。 | 成功后获得 LoRA 权重,使用配对的 LTX-2 19B 生成模型;不代表与其他基础模型兼容。 |
云端任务需要登录和足够积分。Krea 2 需要配置 Fal;WaveSpeed 图片及视频训练需要配置 WaveSpeed 和 R2 存储。
提交云端训练会将所选素材和标注发送给服务商。图片和视频的数据集限制不同,请在提交前确认账号可用。
专注训练准备
把身份特征与偶然细节分开。场景、服装或构图变化后,有效的角色概念仍应保持辨识度。
选择流程前,比较模型家族、版本与开放情况。
读取真实图片尺寸,在导出前检查本地文件限制。
说明变化细节,避免无意中将其当作目标概念学习。
一起导出设置与描述,原始图片文件独立保留。
值得模型学习的创意
从三个方向定义训练概念。每张参考图都链接到对应工作流,包含数据集建议与评估提示词。
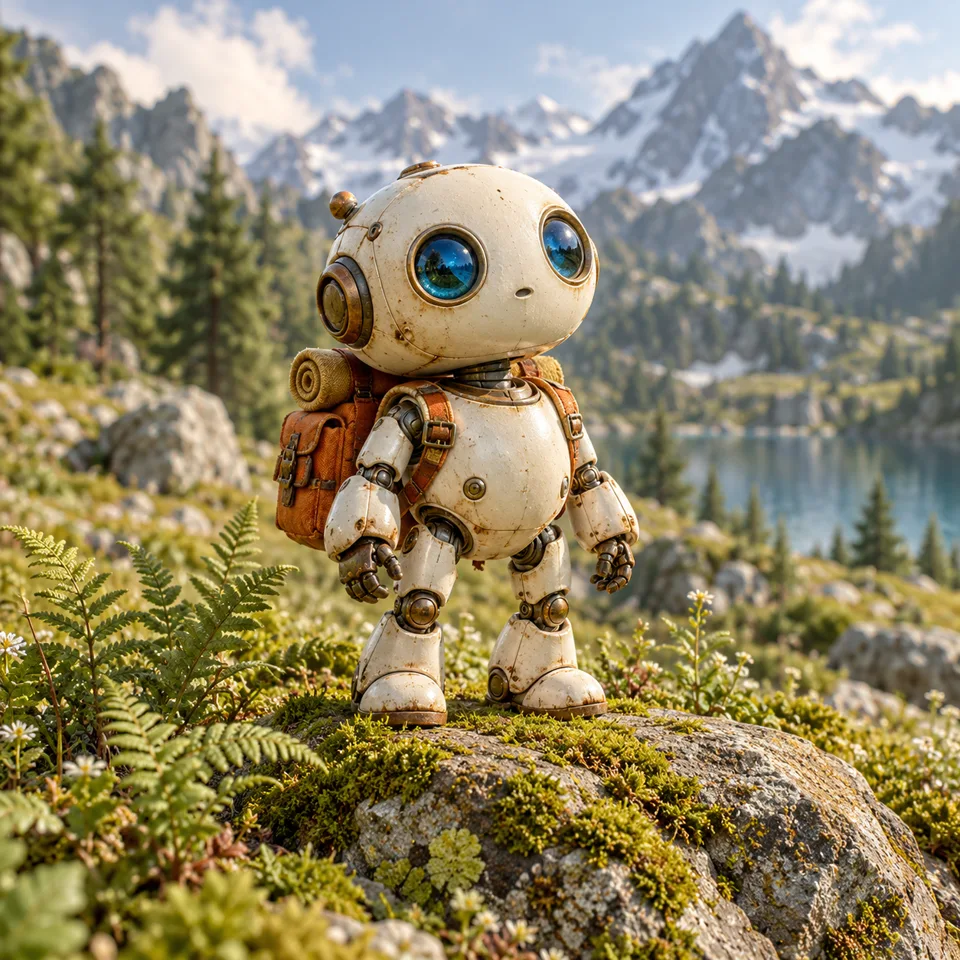
原创陶瓷探险机器人为数据集提供明确的角色身份。变化角度、姿态与环境,避免重复同一种构图。
图片描述示例ohwx_robot, a ceramic explorer with blue glass eyes, standing beside an alpine lake in daylight.
查看角色 LoRA 训练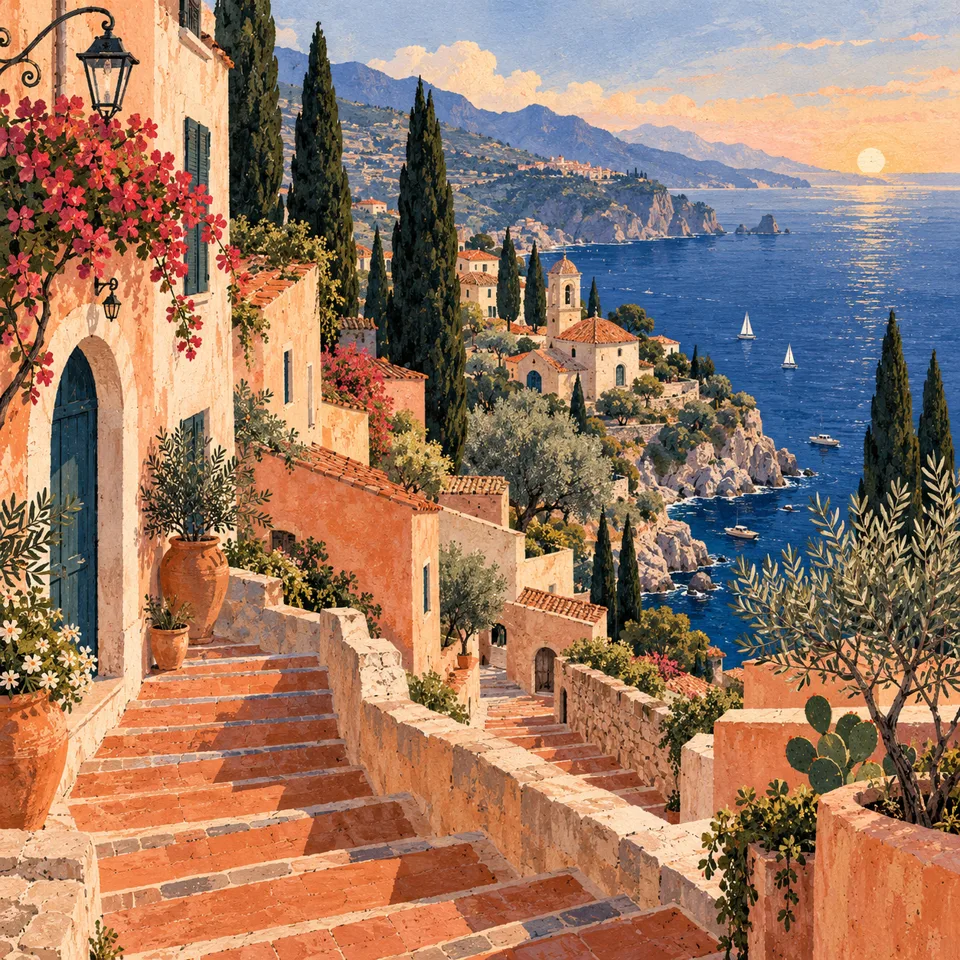
用海岸插画作为视觉语言参考。风格数据集应变换主体,同时保持材质、色彩与笔触的一致性。
图片描述示例A coastal village in ohwx_style, gouache texture, warm flat colors and fine ink contours.
查看风格 LoRA 训练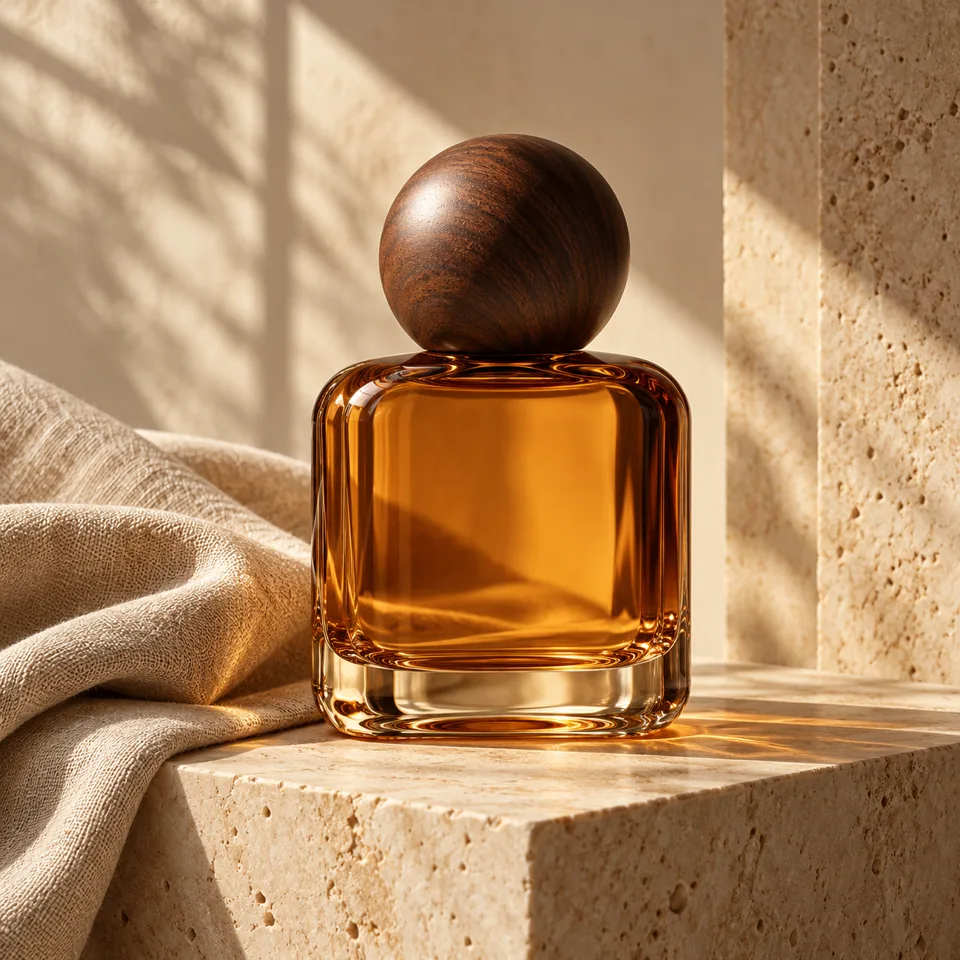
无品牌琥珀色瓶子便于观察形状与材质。补充玻璃瓶身与瓶盖的不同角度,避免只学习同一个背景。
图片描述示例ohwx_bottle, an amber glass bottle with a round walnut cap, on a travertine surface in window light.
查看产品 LoRA 训练这些原创图片由 AI 生成,仅作为概念参考;不是 Loras AI 的训练产物、前后对比或模型性能证明。
从目标到评估
按照所选模型的要求准备图片或视频数据集,检查触发词和标注后提交训练。训练完成后,在对应的生成器中使用权重。
提示词笔记
保存这些思路,用于之后评估兼容的训练适配器。它们是提示词示例,不代表生成结果或效果保证。
ohwx_robot exploring a quiet greenhouse, three-quarter view, soft morning light.
ohwx_robot opening a small field notebook beside a mountain trail, full-body composition.
A close-up portrait of ohwx_robot, blue glass eyes, plain warm gray background, soft studio light.
ohwx_robot standing on a wooden pier at blue hour, gentle reflections, wide composition.
ohwx_robot standing on a neutral background, front view, even lighting, no other objects.
ohwx_robot sitting beside a large fern leaf, low camera angle, natural daylight.
相关笔记
了解素材选择、图片描述、训练设置,以及如何判断模型真正学到了什么。
FAQ
针对所选模型的实用说明,并明确当前开放情况。
把身份特征与偶然细节分开。场景、服装或构图变化后,有效的角色概念仍应保持辨识度。 角色是训练目标,不是基础模型。请选择兼容的图片训练器,并将准确模型版本与角色数据集一起保留。
尝试新的姿势、背景与光线,通过基础模型对照判断身份辨识度,而不是只看是否重现某张训练图。
Krea 2、FLUX.1、FLUX.2 Dev、Qwen Image、Z-Image、Wan 2.2 I2V 和 LTX-2 19B 已接入训练及配套生成。付费任务需要配置服务、登录并准备足够积分。其他目录模型仍为预览。
仅整理本地草稿时,图片在当前浏览器标签页内处理,导出的 JSON 不含原图;刷新或离开会清空本地图片。提交云端训练时,选中的数据集与描述会发送给供应商;WaveSpeed 训练还会使用已配置的 R2 存储保存数据集和归档产物,存储隐私取决于存储桶访问配置。生图会将提示词和所选 LoRA 引用发送给对应服务。请仅提交有权使用的素材。
不能直接互换。需要匹配模型架构、基础版本和加载流程。Krea 2、MOSS 与 Anima 使用各自兼容的权重;名称相似不代表兼容。视频模型的工作流程还可能需要多个适配器文件。
继续探索
选择训练流程前,先比较相关模型家族。适配器格式与基础模型版本必须保持兼容。
选择匹配的模型,整理图片与描述,再提交已开放的训练或生图流程。你也可以先免费导出数据集配置草稿。